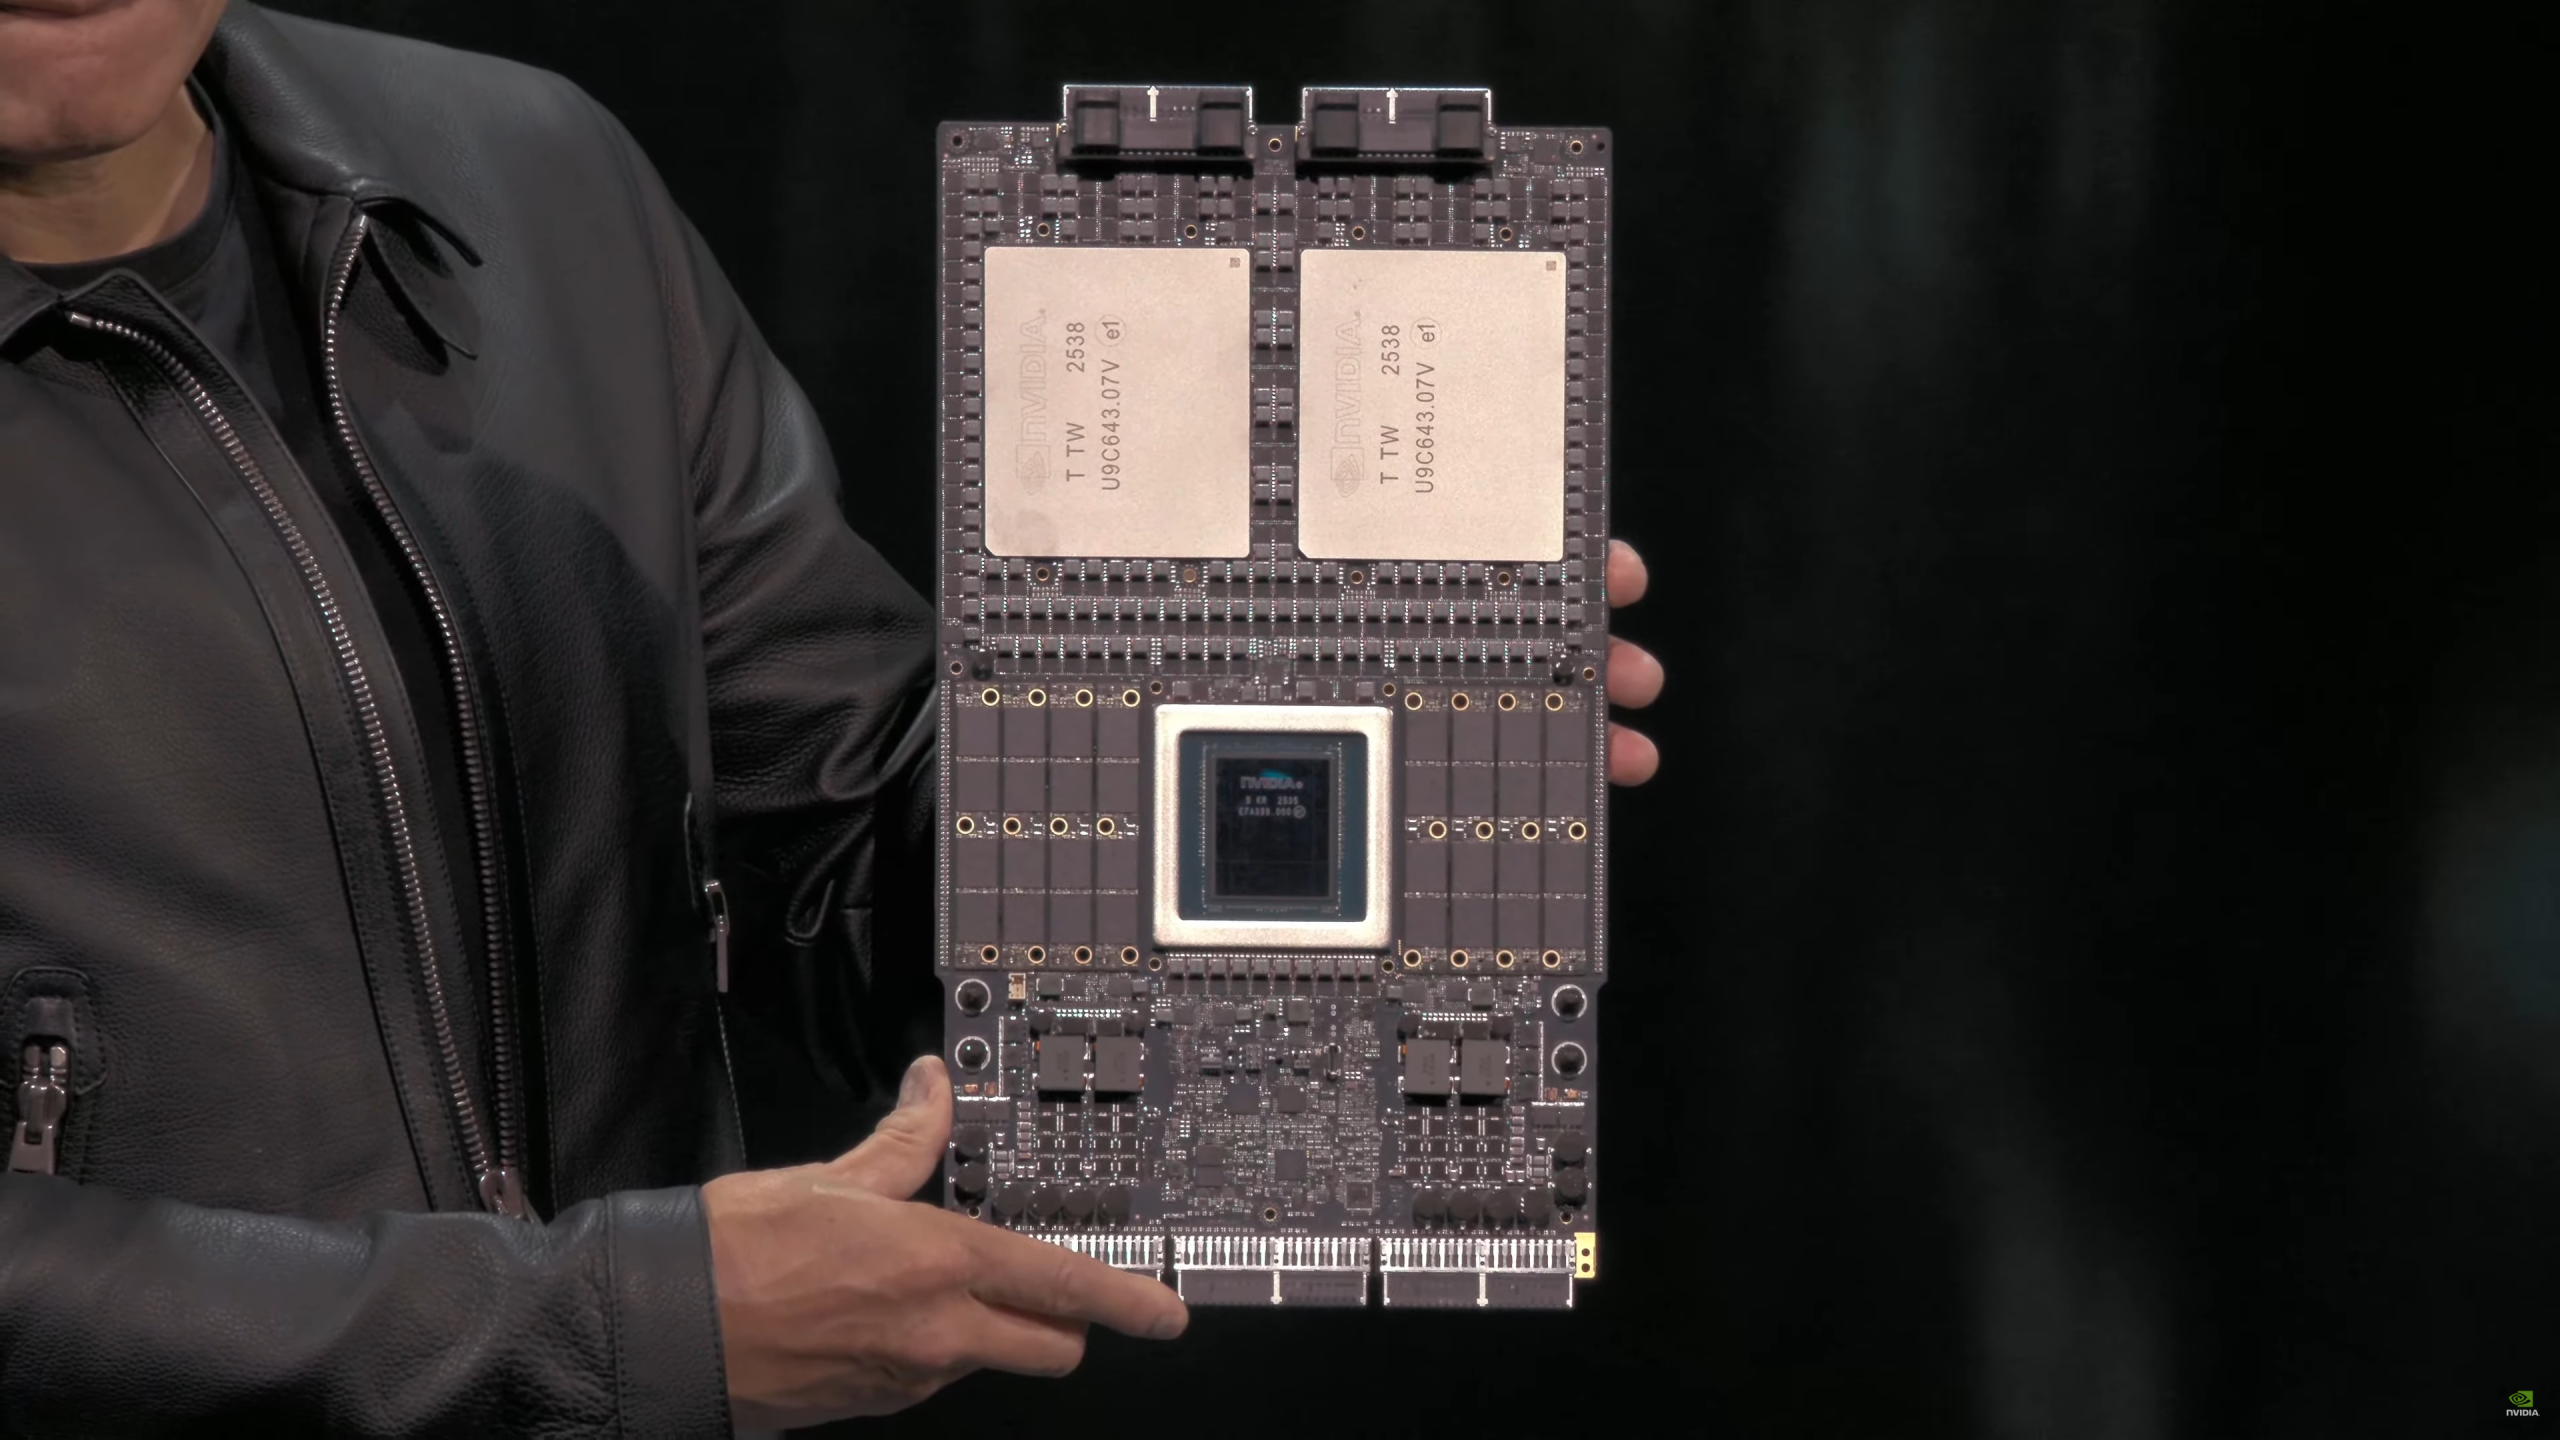


La Nvidia au apărut mici schimbări la platforma Vera Rubin, care vor influența performanța maximă a noilor acceleratoare AI. Din punct de vedere competitiv, acestea reprezintă un pas înapoi față de planurile inițiale, spre bucuria AMD.
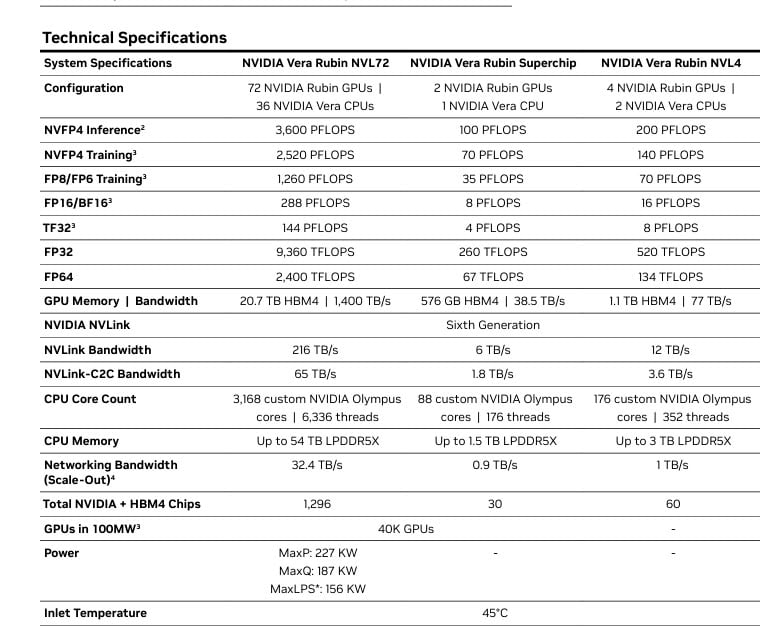
Tabelul oficial de specificații arată că în ultima perioadă s-au modificat mai multe lucruri. Stivele de memorie HBM4 funcționează la o frecvență mai mică, iar lățimea de bandă maximă a interconexiunii NVLink a fost și ea redusă ușor. Aceste schimbări au fost necesare probabil pentru că, în implementarea actuală, vitezele planificate inițial nu puteau fi menținute: sistemul nu era suficient de stabil, iar fiabilitatea avea de suferit. Noile valori restabilesc ordinea, dar în schimb trebuie sacrificată o parte din performanță.
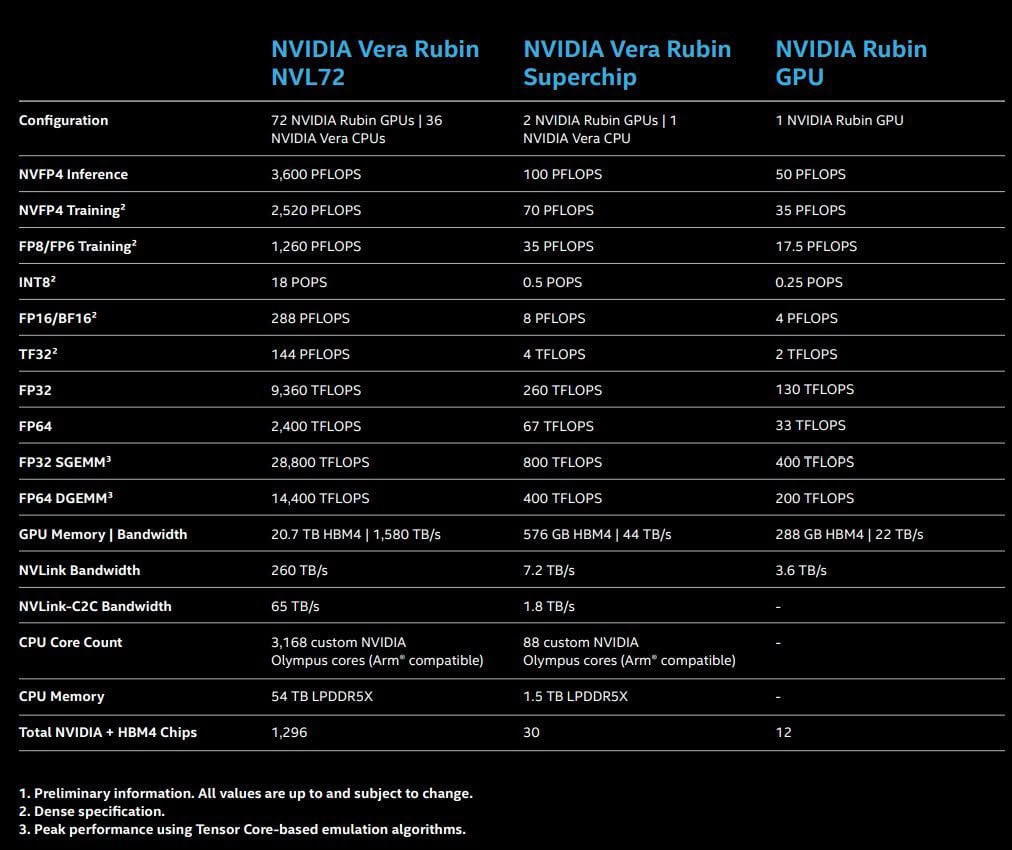
O schimbare importantă este că, la anunțul platformei Vera Rubin, stivele de memorie HBM4 erau pregătite pentru 11,7 Gbps pe pin, iar acum se lucrează cu doar 9,6 Gbps. La rack-urile NVL72 bazate pe Vera Rubin, asta înseamnă că lățimea de bandă efectivă totală a memoriei scade de la 1580 TB/s planificați la 1400 TB/s. Reducerea va diminua în mod cert performanța maximă disponibilă la diverse sarcini, dar amploarea ei exactă ar putea-o arăta doar testele independente, iar efectul real al scăderii de bandă ar depinde puternic de tipul sarcinii.
Următoarea modificare importantă privește interconexiunea NVLink, care conform noilor planuri poate oferi fiecărui GPU o lățime de bandă mai mică decât se aștepta. Inițial se plănuia 18 TB/s, dar valoarea a trebuit redusă la 1,5 TB/s, ceea ce coboară lățimea de bandă a conexiunii bidirecționale de 3,6 TB/s la 3 TB/s. Reducerea poate urmări îmbunătățirea integrității semnalului și a stabilității conexiunii. În spate stă faptul că frecvența Nyquist a NVLink a fost coborâtă de la 56 GHz la 47 GHz. O frecvență mai mică pune o sarcină mai mică pe componente, cum sunt cablurile, SerDes și celelalte elemente, ceea ce ajută la creșterea eficienței producției și a stabilității funcționării. Prin sacrificarea unei părți din performanță în favoarea stabilității, clienții câștigă oricum: este mai bine ca serverul AI să fie stabil și fiabil decât puțin mai rapid, dar instabil din când în când.
Ce înseamnă toate acestea pentru concurență? În esență, rack-ul AMD Helios poate părea o alegere și mai atrăgătoare, cel puțin pe hârtie. Raportul real de forțe îl vor arăta testele independente. Cert este că AMD Instinct MI455X dispune de semnificativ mai multă memorie de mare lățime de bandă decât Nvidia Vera Rubin. Soluția AMD folosește 432GB memorie HBM4 la bord, cu o lățime de bandă de 23,3 TB/s, în timp ce Vera Rubin are doar 288GB, la o lățime de bandă de 19,2 TB/s.
Într-un rack de 72 GPU-uri, la AMD rezultă 31TB memorie HBM4 și o lățime de bandă totală a memoriei de 1,67 PB/s, iar platforma Nvidia Vera Rubin se poate lăuda doar cu 20,7TB memorie și 1,4 PB/s lățime de bandă. Întrucât lățimea de bandă NVLink a scăzut, AMD are avantaj și aici: cu UALoE, fiecărui GPU îi revin 3,6 TB/s bidirecțional, ceea ce înseamnă 260 TB/s lățime de bandă combinată. La Nvidia se aplică doar 3 TB/s bidirecțional, deci și lățimea de bandă combinată este de numai 216 TB/s.
Pe baza celor de mai sus, platforma AMD Helios are avantaj față de Nvidia Vera Rubin la capacitatea memoriei, la lățimea de bandă a memoriei și la lățimea de bandă a interconexiunii. Cât de mult va conta avantajul de pe hârtie în condiții reale și câți clienți vor fi atrași în final spre platforma Helios? Răspunsurile vor veni mai târziu.