



Modelele lingvistice de mari dimensiuni și inteligențele artificiale generative sunt clar capabile să producă rezultate științifice clar și semnificative, mai ales dacă sursa de informații este vastă, fiind cel mai capabil să lucreze cu seturi de date imense. Au fost obținute deja rezultate importante folosind sistemele moderne, aceste metode nu sunt noi, A existat AI și înainte de ChatGPT, și a fost folosit pentru diverse cercetări de amploare. Dar acum OpenAI a făcut un anunț cu totul special.
Compania a reușit să rezolve una dintre cele șapte probleme ale Mileniului, formulate de Institutul de Matematică Clay în anul 2000, pentru care s-a oferit o recompensă de 1 milion dolari. Per problemă.
OpenAI a indicat imediat că nu dorește recompensa, dar a adăugat imediat că această sumă nu ar fi suficientă pentru a acoperi costurile implicate de această descoperire.
Compania a reușit să rezolve ecuațiile Navier–Stokes, vechi de peste 90 ani, care descriu mișcările și a curgerea substanțelor lichide. Doar una din probleme a fost dezlegată, ipoteza Poincaré. OpenAI a desfășurat cea mai intensă activitate de cercetare din istorie pentru a obține noul rezultat. Conform raportului, procesul a consumat o capacitate de calcul de „câteva milioane de dolari”, deși nu a durat mult.
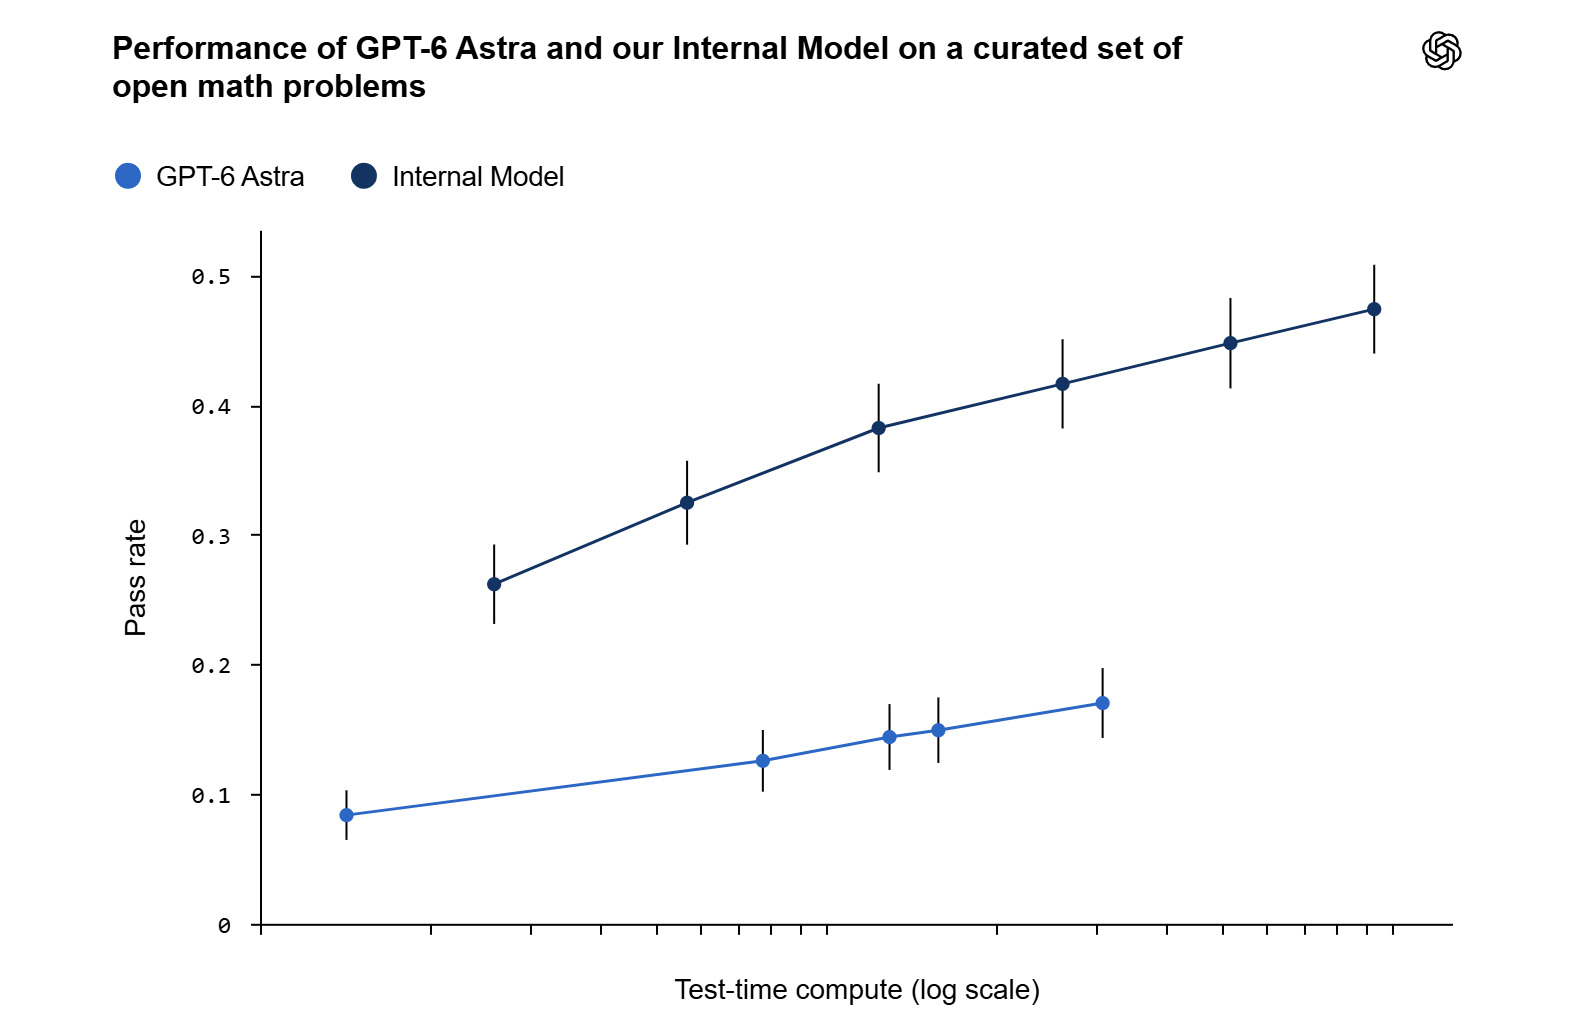
Efortul OpenAI a dat rezultate în 88 ore. Pe 28 August s-a început antrenarea unui model nou intern, cu o capacitate de calcul de trei ori mai mare decât cel al lui GPT-6 Astra prezentat recent destul de performant în sine. Așadar, este vorba de un model extraordinar, care a creat peste 10.000 agenți AI, care au lucrat în mare parte în paralel, și fără întrerupere.
Vestea confirmării soluției este îmbucurătoar, dar o coincidență ciudată conferă acestei povești un gust amar. Chiar cu o zi înainte, matematicianul Tristan Buckmaster de la Universitatea din New York și Levent Alpöge, unul dintre cercetătorii de la Anthropic, au prezentat descoperiri importante legate de ecuațiile Navier–Stokes. Se pare că Alpöge a aflat prin intermediul relațiilor sale din cadrul companiei că OpenAI a luat cunoștință de cercetarea lor și că firma a avut acces la informații esențiale.
Buckmaster a declarat că OpenAI a folosit și rezultatele lor pentru a antrena modelul. Discuția s-a transformat foarte repede într-o dispută verbală mai puțin științifică.
Nu se știe nimic despre contextul exact al cazului, dar Buckmaster a sugerat că OpenAI ar fi putut obține acces la sesiunile de lucru înregistrate în sistemul Codex, și că ar fi putut folosi informațiile de acolo pentru antrenament. Matematicienii au folosit mai multe modele lingvistice, chiar și ChatGPT. Acum profesorul așteaptă ca OpenAI să facă publică demonstrația soluției, care va dezvălui toate sursele folosite.