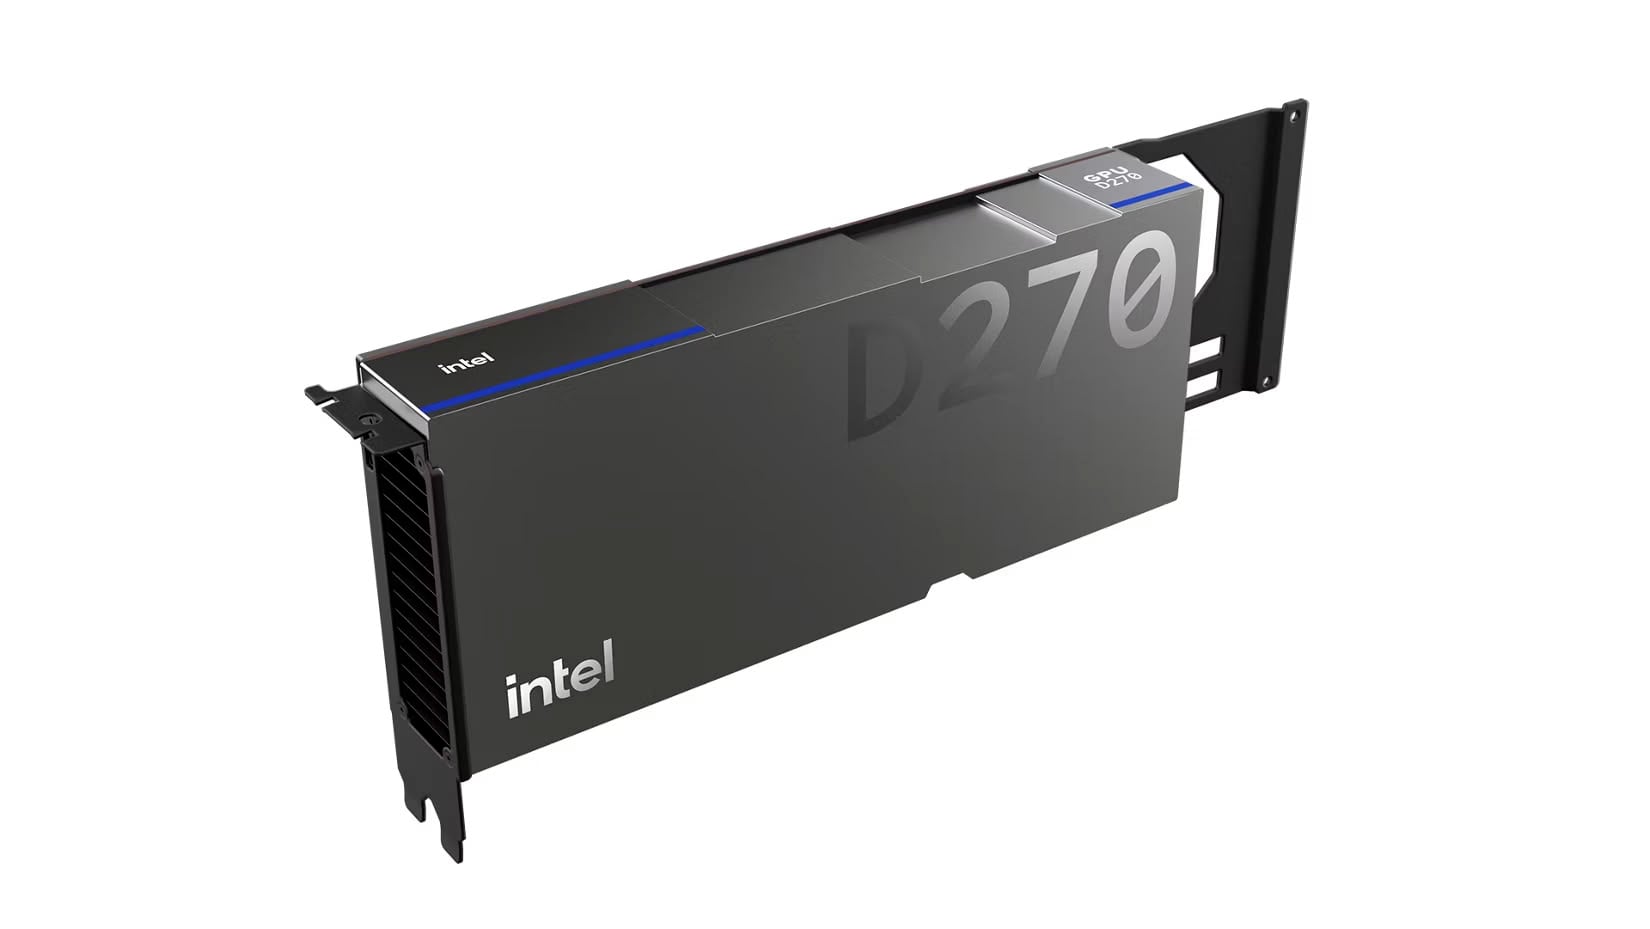




Intel a dezvăluit recent cea mai nouă serie de acceleratoare AI, denumită GPU D-Series, ai cărei membri poartă numele de cod Crescent Islands.
La baza noilor acceleratoare AI se află un GPU cu 32 de nuclee Xe3P, completat cu 256 de motoare XMX și 32 MB de cache unificat de nivel doi. Nu s-a precizat însă cât de lată va fi magistrala de memorie, dar se știe că la GPU pot fi conectați maximum 480 GB de memorie LPDDR5X. Modelul de bază realizat de Intel vine „doar" cu 160 GB de memorie, însă echipa Intel le oferă partenerilor AIB posibilitatea de a realiza chiar și modele de 480 GB, ba chiar, potrivit unui leaker, unii parteneri ar putea veni și cu versiuni de 512 GB, dar deocamdată niciuna dintre părți nu a confirmat oficial acest lucru. Lățimea de bandă a memoriei ar urma să fie de 1,5 TB/s, deci GPU-ul nu duce lipsă la acest capitol.
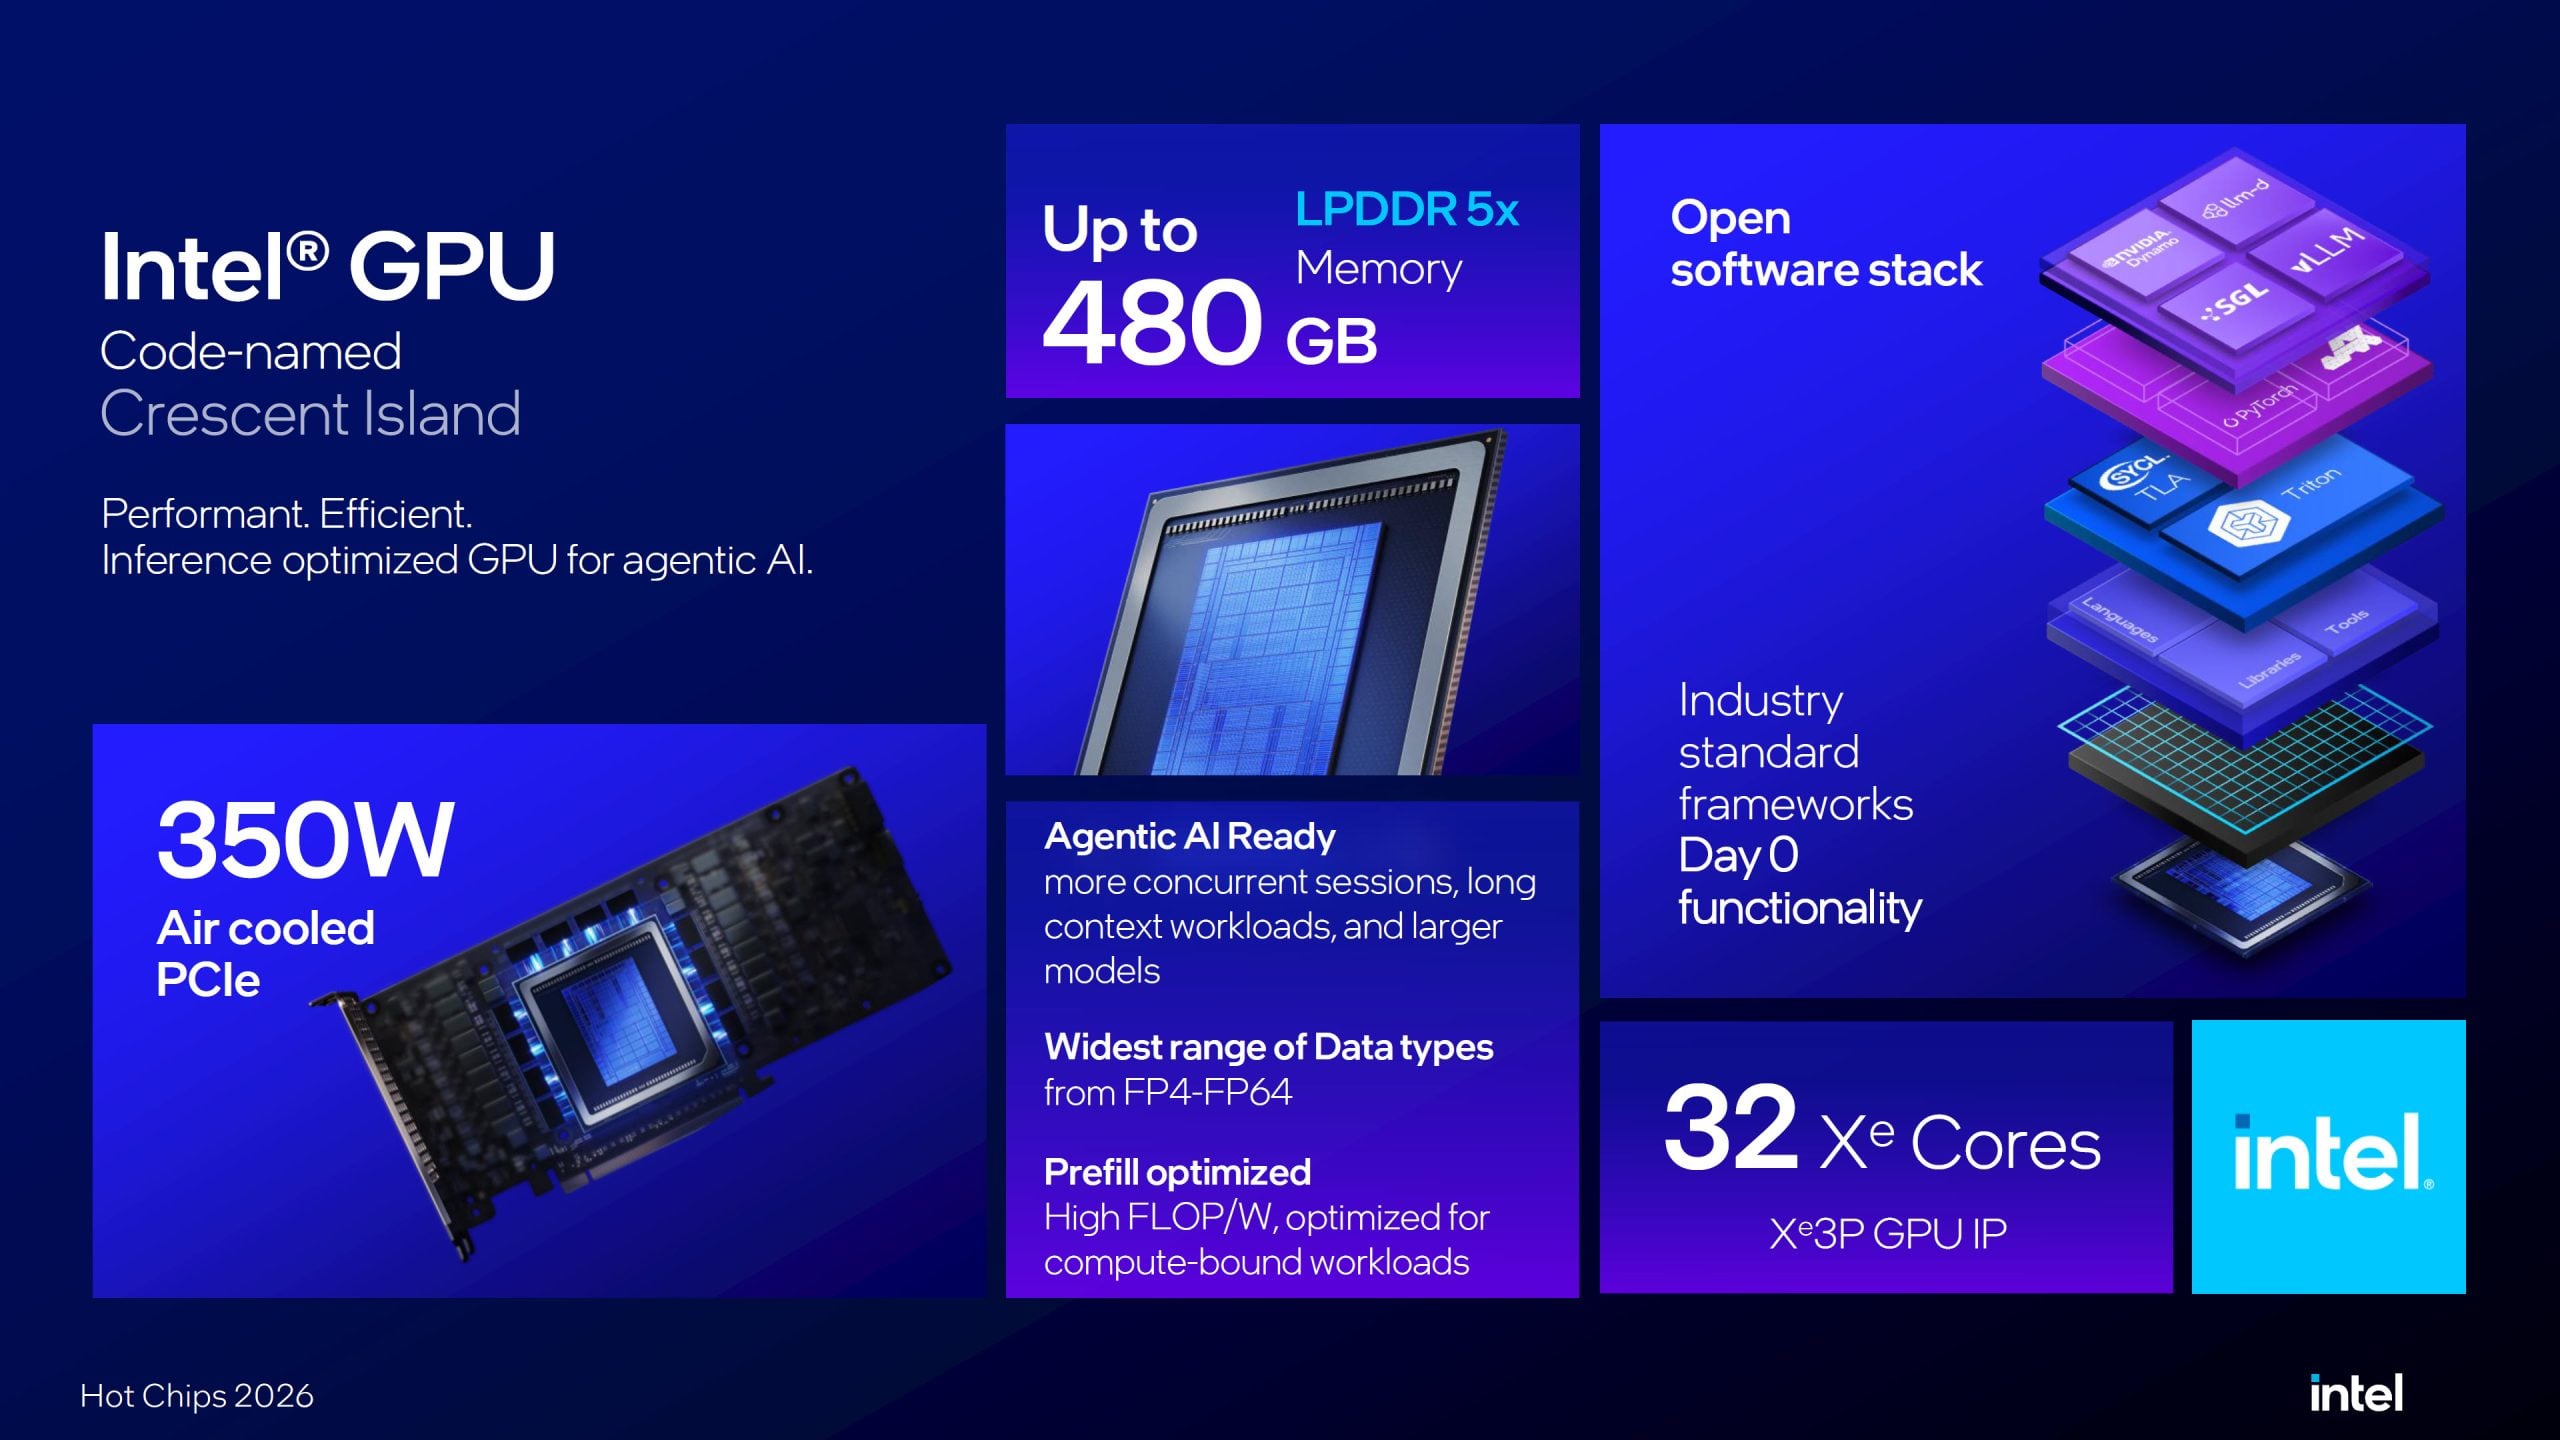
GPU-ul în sine poate oferi o putere maximă de calcul de 1,3 PetaFLOP/s la sarcinile FP8, iar gama formatelor de date acceptate este mult mai largă, de la FP4 până la FP64, deci noul produs se potrivește pentru foarte multe tipuri de sarcini. GPU-ul are și un motor media performant, construit în jurul a patru unități de codare și patru unități de decodare, ceea ce îi sporește și mai mult capacitatea.
În cazul motoarelor XMX, un lucru interesant este că au fost reproiectate, astfel că, față de soluțiile bazate pe Xe3, structura de procesare a datelor are acum o adâncime de 16 niveluri în loc de 4, ceea ce permite gestionarea unei densități mai mari de date, cu efecte benefice asupra fluxului diverselor sarcini și asupra performanței în sine. Datorită array-urilor sistolice mai adânci, anumite părți ale pipeline-ului au o structură mai simplă, ceea ce favorizează atingerea unor frecvențe mai mari de funcționare, dar permite și o eficiență energetică mai ridicată.
Noul design se potrivește foarte bine particularităților diverselor sarcini AI, de exemplu rulării modelelor lingvistice mari moderne (LLM). Au fost mărite și fișierele de registre, care ajung la o capacitate de 1 MB per nucleu, în timp ce cache-ul L1 per nucleu are 512 KB. Designul este alcătuit în total din 256 de motoare XMX și 256 de motoare vectoriale, din care fiecărui nucleu Xe3P îi revin câte opt din fiecare. Arhitectura Xe3P a fost creată exclusiv pentru accelerarea sarcinilor AI, așa că nu include nicio secțiune de procesare grafică. Potrivit planurilor Intel, un singur astfel de accelerator AI poate rula un model lingvistic mare de până la 300 de miliarde de parametri, iar un sistem cu opt plăci poate rula fără probleme și LLM-uri cu un trilion de parametri.
Pentru GPU D-Series este stabilit un TDP de 350 W, iar produsul folosește o interfață PCI Express 5.0 x16 și răcire cu aer. Aici nu trebuie să ne gândim la o răcire cu ventilator propriu, ci la ventilatoarele de sistem integrate în serverul respectiv, care suflă aerul proaspăt printre lamelele radiatorului. Mostre ale noilor acceleratoare AI sunt deja livrate partenerilor, dar deocamdată nu se știe când vor deveni disponibile produsele pe scară mai largă, iar despre prețuri nu s-a vorbit nici ele, cel puțin deocamdată.